**GPT-SoVITS不支持情绪提示词,靠【参考音频】控制音色韵律)
以下是三种常用男声参考文本,可直接照着录音,录完即作为固定参考文本使用:
模板 A:沉稳解说型(纪录片 / 科普 / 知识类旁白首选)
在这片广袤的土地上,每一寸土壤都承载着岁月的痕迹。时间,是最公正的见证者。
· 字数:32 字,约 6~7 秒
· 语气要求:平稳、低沉、句尾微降
模板 B:磁性叙事型(故事 / 情感 / 有声书旁白首选)
那天晚上,雨下得很大。他站在窗前,望着远处模糊的灯光,久久没有说话。
· 字数:31 字,约 6~7 秒
· 语气要求:低沉、带停顿、有呼吸感、第二句放慢
模板 C:激昂宣传型(广告 / 宣传片 / 开场词首选)
突破极限,超越自我。每一次出发,都是为了抵达更远的远方。
· 字数:26 字,约 5~6 秒
· 语气要求:有力、节奏明快、句尾上扬收束
36. 下方输入要合成的文本(语种对应),长文本点「凑四句一切」(不切,超过约几百字会胡言乱语;8GB 显存更建议按句切)。
37. 点「合成」,试听满意即可下载 wav。
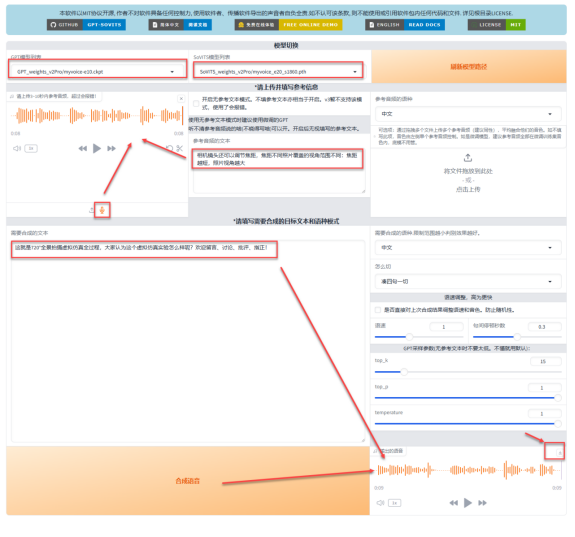
38. 不满意先调参考音频(换一段、语速语气更贴合的),比调参数管用;top_p/top_k/temperature 保持默认。
_ueditor_page_break_tag_
第 6 步:批量配音并接入现有成片
方式 A:WebUI 手动逐条(8 句讲解稿,几分钟搞定)
· 把每句讲解文本依次粘贴合成,导出 wav 命名为 clip_1.wav…clip_8.wav 之类。
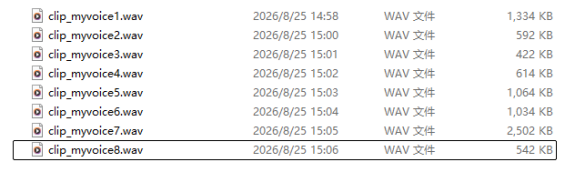
方式 B:API 批量(几十上百句时)
· 启动 api_v2.py 起本地服务,脚本循环调用合成,一句一条。
· 参考:程序根目录\api_v2.py、batch_inference.py。
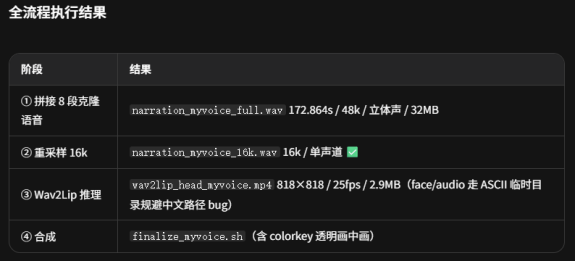
接入成片管线(10-视频渲染 现有流程):
合成好的整段旁白 → 命名 narration_male.wav → 覆盖/替换原文件
→ 运行 finalize_explain.sh(ffmpeg 合并画面+配音+字幕)
字幕脚本 gen_subtitles.py 不用改——它只读 wav 的时长来对齐字幕。
常见问题对照表
现象 |
原因 |
处理 |
合成的声音不像你 |
参考音频太差/太短 |
换 5s 干净参考音频;检查 ASR 标注有没有错字 |
训练时显存爆(OOM) |
batch 太大 / 切片太长 |
batch 降到 1;切片手动切到 8s 内 |
长文本合成胡言乱语 |
一次合成太长 |
点「凑四句一切」,或手动按句切 |
有金属音/吞字 |
模型轮数过高学到杂音 |
训练素材先 UVR5 去杂音;降低 SoVITS 轮数 |
打不开新页面 |
浏览器弹窗拦截 |
手动开控制台提示的端口(9872/9873/9874) |
训练中断 |
正常现象 |
直接再点开始,自动续训 |
8GB 显存参数速查(来自 v2pro 实测)
项 |
8GB 卡推荐值 |
SoVITS 训练 batch_size |
1(切片 10s 时上限) |
GPT 训练 batch_size |
2(未开 dpo 时上限) |
GPT 轮数 |
10(≤20) |
dpo 训练 |
❌ 12GB 以下不支持 |
切片最大时长 |
≤8s(长必爆显存) |
单次合成文本量 |
几十字内最稳,超了按句切 |
生成日期:2026-08-18


 2026年05月01日 2026年05月01日
 2026年04月11日 2026年04月11日
 2026年04月01日 2026年04月01日
 2026年01月22日 2026年01月22日
 2024年05月15日 2024年05月15日
 2024年03月18日 2024年03月18日
 2023年02月24日 2023年02月24日
 2023年02月23日 2023年02月23日
 2022年06月21日 2022年06月21日
 2022年05月26日 2022年05月26日