TTS( Text-to-Speech,文字转语音)是可以把任意文字自动变成可播放语音的系统——通俗说就是"让机器念稿"。它内部要跑三步:
文本分析:先读懂文字的语言学结构(分词、读音、断句、重音)。
声学模型:决定"怎么读"——语调、语速、情感的声学特征(频谱)。这一步就是情绪/音色差异产生的地方。
声码器:把声学特征还原成最终的波形音频。
整条配音流水线就是 解说词文本 → edge-tts(调用 Neural TTS) → mp3 → ffmpeg 混进成片。其中第 2 步的"音色模型",就是选音色、选情绪(newscast/cheerful/angry)等声音参数。
而我们如果想用我们自己的声音(或特定人的声音)来配音的话,就需要克隆自己(或他人)的声音,并替代为第 2 步选用的声音模型就可以了。
GPT-SoVITS 是开源界的"少样本语音克隆 + 文本转语音"一体化工具——核心特点是极低的数据门槛:5 秒音频零样本克隆,1 分钟录音微调后高度还原本人嗓音,全部本地离线零成本运行——可以协助你克隆自己的特色语音并为任何文字进行配音。
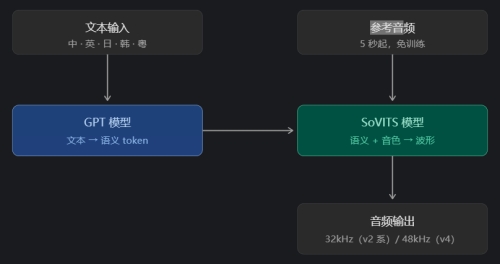
GPT-SoVITS中GPT 只管"说什么"(语义),SoVITS 只管"谁在说"(音色)。所以换音色只需换参考音频或替换 SoVITS 权重,文本前端完全不用动——也解释了为什么它比传统 TTS 更抗低质量素材。GPT-SoVITS可以提供四类能力:
1、零样本克隆:给 5 秒参考音频即刻合成,不训练、不等待,适合快速试听与临时配音;
2、少样本微调:1 分钟录音训练专属权重,音色相似度与稳定性显著提升,适合成片级配音;
3、跨语种合成:中文素材训练的音色可直接说英、日、韩、粤,无需对应语种的训练数据;
4、一体化工具链:UVR5 人声分离、音频自动切分、多语种 ASR 标注与文本校对内置,攒数据集不必另找工具。


 2026年05月01日 2026年05月01日
 2026年04月11日 2026年04月11日
 2026年04月01日 2026年04月01日
 2026年01月22日 2026年01月22日
 2024年05月15日 2024年05月15日
 2024年03月18日 2024年03月18日
 2023年02月24日 2023年02月24日
 2023年02月23日 2023年02月23日
 2022年06月21日 2022年06月21日
 2022年05月26日 2022年05月26日