● ① 什么是 TTS
TTS = Text-to-Speech(文字转语音):把任意文字自动变成可播放语音的系统——通俗说就是“让机器念稿”。
它内部固定跑三步,中间的“引擎”就是 TTS 的核心:
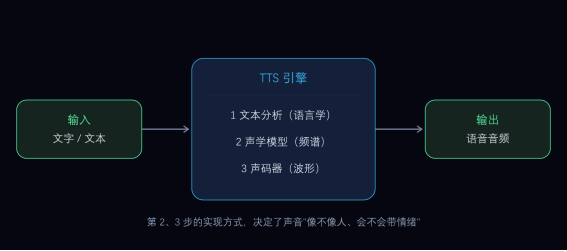
图 1 · TTS 把文字经“文本分析 → 声学模型 → 声码器”三步变成音频
● ② 什么是神经嗓音
神经嗓音 = 用**深度神经网络**实现的语音合成结果。它不是某一个具体声音,而是语音合成技术的“代际”。名字带 -Neural 后缀的声线都属此类。
传统合成(拼接 / 参数) |
神经合成(Neural TTS) |
· 机械感、语调平直
· 几乎无法自然表达情绪
· 2010 年前主流,已淘汰
· 听感:机器人念稿 |
· 深度神经网络端到端
· 自然流畅、接近真人
· 支持语调 / 情绪(express-as)
· 听感:像真人在说话 |
澄清:晓晓 / 云希 / 晓伊 / 方言声线全是神经嗓音。它们彼此区别的是“身份 / 音色”,共用的技术代际都是 Neural——这正是前几轮试听都自然的原因。 |
● ③ 两者到底什么关系
一句话:TTS 是总技术,神经嗓音是 TTS 引擎内部第 2、3 步的一种实现方式。两者不是并列,而是“容器与内容”的包含关系。
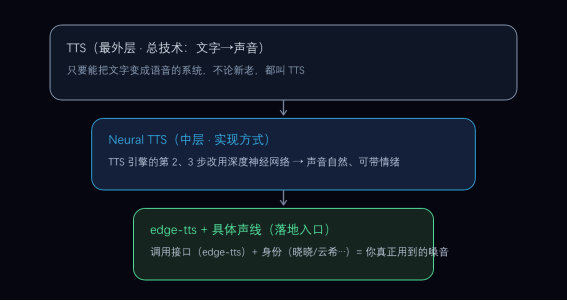
图 2 · 包含关系:TTS ⊃ Neural TTS ⊃ edge-tts+声线
常见误区:把“神经嗓音”当成某一个特定声音。正确理解——它是技术属性(第 2、3 步用没用神经网络),而“晓晓 vs 云希”是身份属性(音色不同)。同一代技术下,可以有成百上千个不同身份的神经嗓音。 |
● ④ 落到你的教学视频配音
你整条配音流水线,本质就是上面这套关系链的实例化:
解说词文本 → edge-tts(调用 Neural TTS 引擎)→ mp3 → ffmpeg 混进成片 |
三个可调旋钮,对应 TTS 引擎的不同位置
你要调的 |
对应 TTS 的哪一步 |
具体怎么做 |
换音色 / 身份 |
第 2 步(声学模型里选不同神经声线) |
换 Voice:晓晓 / 云希 / 晓伊 / 方言 |
换情绪 / 语气 |
第 2 步(express-as 风格参数) |
style="newscast|cheerful|angry|…" |
换语种 |
第 1 步(文本分析)+ 第 2 步声线 |
选对应语言神经声线 |
教学场景的推荐映射(已在试听页验证)
教学环节 |
推荐声线 |
推荐情绪 |
作用 |
概念讲解 |
晓晓 |
newscast / calm |
清晰权威、信息密度高 |
开场 / 互动 |
晓晓 chat · 云希 cheerful |
chat / cheerful |
拉近距离、激活注意 |
操作演示 |
晓晓 |
gentle / friendly |
像手把手带练 |
重点 / 警示 |
晓晓 |
serious / angry |
强调关键、避免翻车 |
章节收尾 |
晓晓 |
lyrical / calm |
抒情留白、强化记忆 |
进阶路线:想用“自己的声音”讲,只需把第 2 步的声学模型换成 GPT-SoVITS / Fish Speech 这类“你的声纹”模型,流程骨架完全不变——这就是本地克隆声线的落点。 |
● ⑤ 名词速查表
名词 |
是什么 |
在你的项目里 |
TTS |
文字转语音的总称 |
整条配音技术的名字 |
Neural TTS |
TTS 引擎第 2、3 步用神经网络实现 |
你生成的配音都基于它 |
神经嗓音 |
Neural TTS 产出的声音(技术属性) |
晓晓 / 云希等 -Neural 声线 |
声线 / Voice |
神经嗓音的“身份”(音色) |
zh-CN-XiaoxiaoNeural 等 |
express-as |
SSML 里切换情绪/风格的标签 |
style="cheerful" |
edge-tts |
调用微软 Neural TTS 的免费接口 |
你前几轮生成 mp3 用的工具 |
一句话收尾:TTS 是方法,神经嗓音是这种方法里最新、最像人的一代产物;你选“晓晓还是云希”是在选身份,选“newscast 还是 cheerful”是在调情绪,二者都跑在同一套 Neural TTS 引擎上。


 2026年05月01日 2026年05月01日
 2026年04月11日 2026年04月11日
 2026年04月01日 2026年04月01日
 2026年01月22日 2026年01月22日
 2024年05月15日 2024年05月15日
 2024年03月18日 2024年03月18日
 2023年02月24日 2023年02月24日
 2023年02月23日 2023年02月23日
 2022年06月21日 2022年06月21日
 2022年05月26日 2022年05月26日