-
 "嘴动+头微动"的本地口播数字人制作一、主要功能与技术原理SadTalker(CVPR 2023,西安交大 & 腾讯 AI Lab)功能:单张人像照片 + 一段语音 → 生成会“说话”的头像视频,不仅动嘴,还带头部姿态、眨眼、眉毛等自然微动作。技术原理:核心思想是把“说话”分解为头部运动建模 + 面部运动建模两条 3D 线索,再统一映射到生成空间:ExpNet(表情系数网络):从音频回归出 3DMM 表情系数(lip region 深度感知,专门强化唇部)P...
-
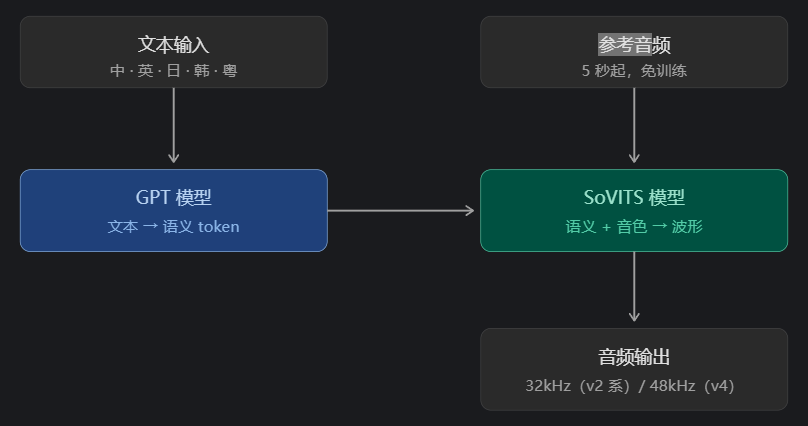 TTS( Text-to-Speech,文字转语音)是可以把任意文字自动变成可播放语音的系统——通俗说就是"让机器念稿"。它内部要跑三步:文本分析:先读懂文字的语言学结构(分词、读音、断句、重音)。声学模型:决定"怎么读"——语调、语速、情感的声学特征(频谱)。这一步就是情绪/音色差异产生的地方。声码器:把声学特征还原成最终的波形音频。 整条配音流水线就是 解说词文本 → edge-tts(调用 Neural TTS) → mp3 → ffmpeg 混...
-
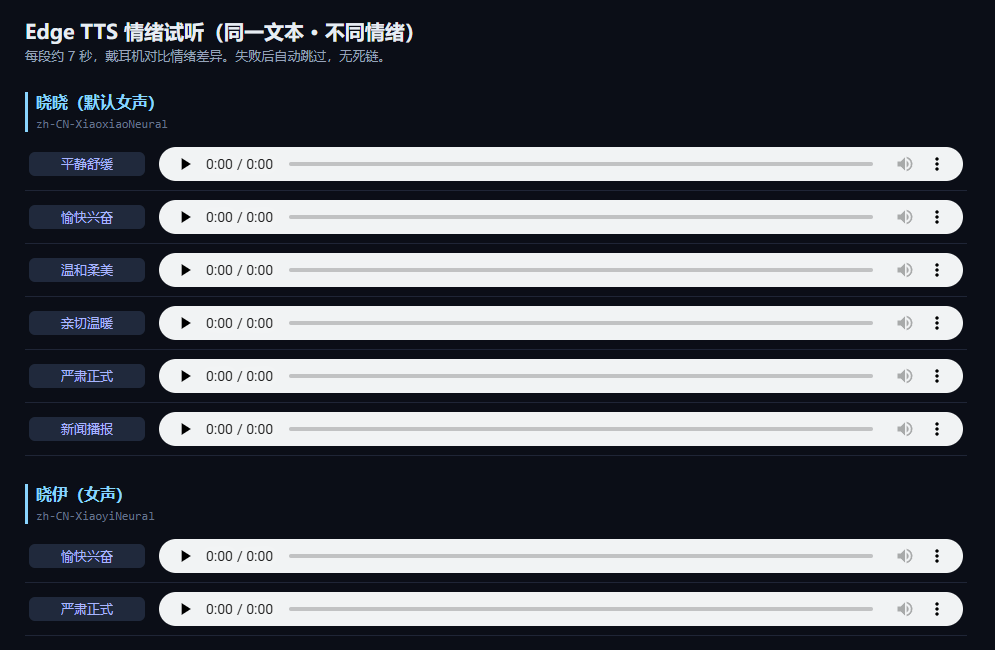 ● ① 什么是 TTSTTS = Text-to-Speech(文字转语音):把任意文字自动变成可播放语音的系统——通俗说就是“让机器念稿”。它内部固定跑三步,中间的“引擎”就是 TTS 的核心: 图 1 · TTS 把文字经“文本分析 → 声学模型 → 声码器”三步变成音频● ② 什么是神经嗓音神经嗓音 = 用**深度神经网络**实现的语音合成结果。它不是某一个具体声音,而是语音合成技术的“代际”。名字带 -Neural 后缀的声线都属此类。传统合成(拼...
-
 手机日益成为人们必不可少的工具,但由于其屏幕过小,无法有效满足为多人演示或展示的场景,此时手机投屏就变得很有必要了。手机投屏就是借助软硬件工具将手机小屏幕投放到电视、LED大屏、投影幕布等较大屏幕。 本文就介绍如何实现手机屏幕与同一无线网络内的Windows电脑(无线网卡连接)实现手机投屏,此方法的优势是仅需要安装必要的windows组件,而无需安装第三方软件,也无须借助第三方硬件设备。 一、安装windows无线...
-
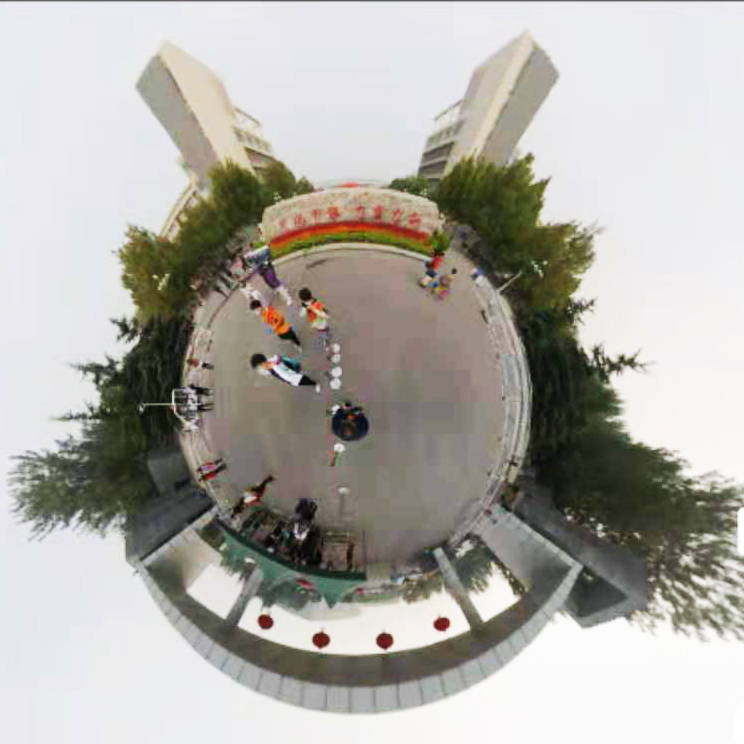 Panorama是基于摄影技术、全景图像缝合与播放技术的虚拟现实技术,它能完美展现固定地点全视角空间真实风景效果,所以是绝佳的图像展示技术之一。全景又称全景图像,是指大于双眼正常有效视角(大约水平90度,垂直70度)或双眼余光视角(大约水平180度,垂直90度),乃至360度完整场景范围拍摄的照片。根据全景外在表现形式可以分为柱形全景、球形全景和立方体全景三大类。柱形全景是最简单的全景,就是通常所说的“环视”,通...


