数字人(Digital Human / Virtual Human)本质上是“人的形象 + 人的表达能力"在数字世界的代理”。几款数字人制作软件对比情况如下:
| 数字人方案 |
头/脸 |
嘴 |
身体 |
真人感 |
本地难度 |
| Wav2Lip |
几乎不动 |
锐利 |
完全不动 |
半身静态 |
✅ 简单 |
| SadTalker |
微动+眨眼 |
自然 |
不动 |
半身自然 |
✅ 简单 |
| SadTalker→Wav2Lip 精修 |
微动+眨眼 |
最锐 |
不动 |
半身最佳 |
✅ 简单 |
| LivePortrait / DiffPose |
头部驱动 |
自然 |
也不动 |
半身 |
需装模型 |
| MagicAnimate / Animate Anyone |
姿态驱动 |
自然 |
✅ 可做全身肢体 |
需视频输入 |
算力高、8GB 显存吃紧 |
| 雨课堂这种 SaaS 全身+肢体 |
全身 |
自然 |
✅ |
真人 |
❌ 需付费 API
|
我们可以对数字人从四个维度进行分类:
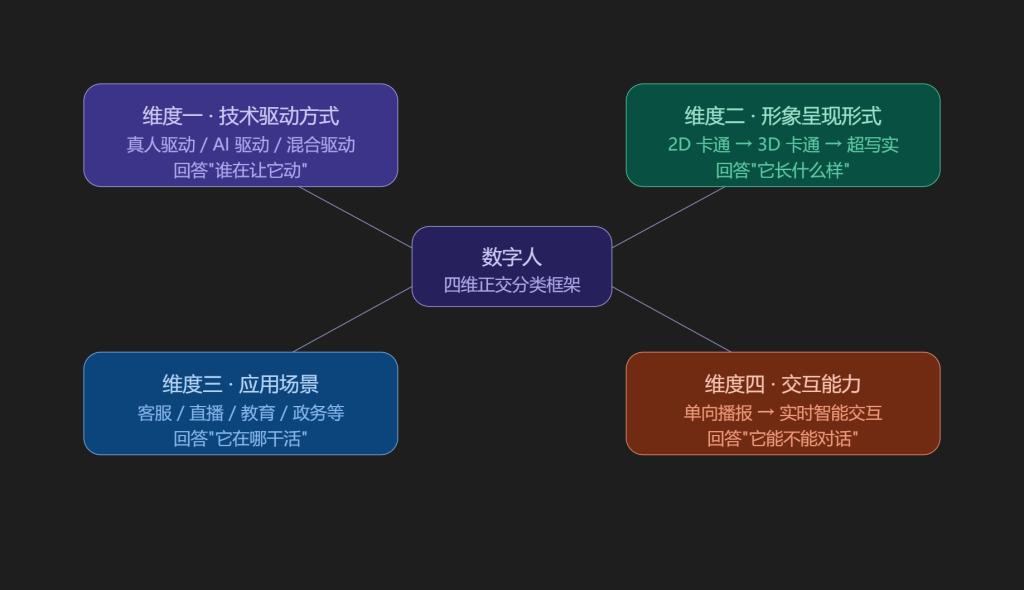
维度一:按技术驱动方式分类
这是最核心的一条分类线,回答的问题是——数字人的动作、表情、语言,到底"谁在背后让它动"。可分为真人驱动型、AI 驱动型和介于两者之间的混合驱动型:
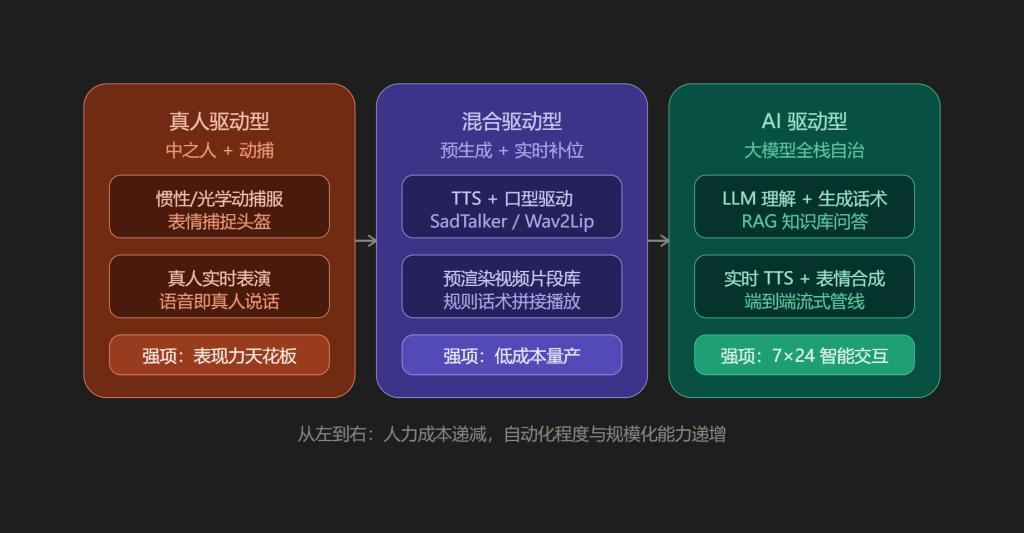
三种驱动方式的详细对比:
1. 真人驱动型(中之人模式)
核心特征:背后有一个真人(业内称"中之人")穿戴动捕设备实时表演,数字形象只是"皮"。动作、表情、语气全部由真人赋予。
技术要点:惯性/光学动捕 + 面部捕捉(iPhone ARKit、头盔摄像头)+ 实时渲染引擎(Unreal/Unity + Live Link)+ 低延迟推流。关键指标是端到端延迟(直播要求 <500ms)。
典型案例:虚拟主播圈的主流模式——绊爱(Kizuna AI)早期、A-SOUL、彩虹社 VTuber;虚拟演唱会(如初音未来实为预编排,洛天依演出为动作库+实时调校)。
优点:表现力是天花板,临场反应、情感细腻度无可替代,粉丝与"中之人"产生真实情感连接。
缺点:一场直播就要一个真人全程在线,无法 7×24 规模化;设备与人力成本高;存在"中之人"依赖风险(解约、人设崩塌)。
2. AI 驱动型
核心特征:从理解用户输入、生成话术、合成语音到驱动表情口型,全链路由 AI 完成,无需真人在场。
技术要点:ASR(语音识别)→ LLM(大模型理解与生 成,常挂 RAG 知识库)→ TTS(语音合成/声音克隆)→ 口型与表情驱动(Audio2Face、SadTalker、实时渲染)。难点在流式管线——要边生成边播,把首轮响应延迟压到 1~2 秒内。
典型案例:银行数字员工(浦发"小浦")、AI 主播带货(京东言犀数字人直播)、政务大厅智能问答一体机。
优点:边际成本趋近于零,一套系统可服务上万人并发,7×24 不间断,回答口径统一可控。
缺点:表现力偏"稳"而不"活",长时间观看易察觉机械感;对开放域闲聊和突发情况的应变弱于真人;大模型幻觉带来内容合规风险。
3. 混合驱动型(当前产业主流)
核心特征:常规时段 AI 值守,高峰/重要场次真人接管;或话术用 AI 生成、形象用预渲染素材拼接。这正是您 SadTalker 工作流的形态——静态头像 + 克隆语音 + 口型驱动,离线批量生成讲解视频,属于"预生成式 AI 驱动"。
优点:成本与效果的平衡解,教学视频、新闻播报这类"内容确定"的场景性价比最高。
缺点:交互能力弱,基本只能单向输出或做有限的关键词应答;素材复用痕迹明显时观众会有"复读机"感。
维度二:按形象呈现形式分类
这条线回答"它长什么样",本质是一条写实度光谱,而写实度直接决定建模成本与"恐怖谷"风险:
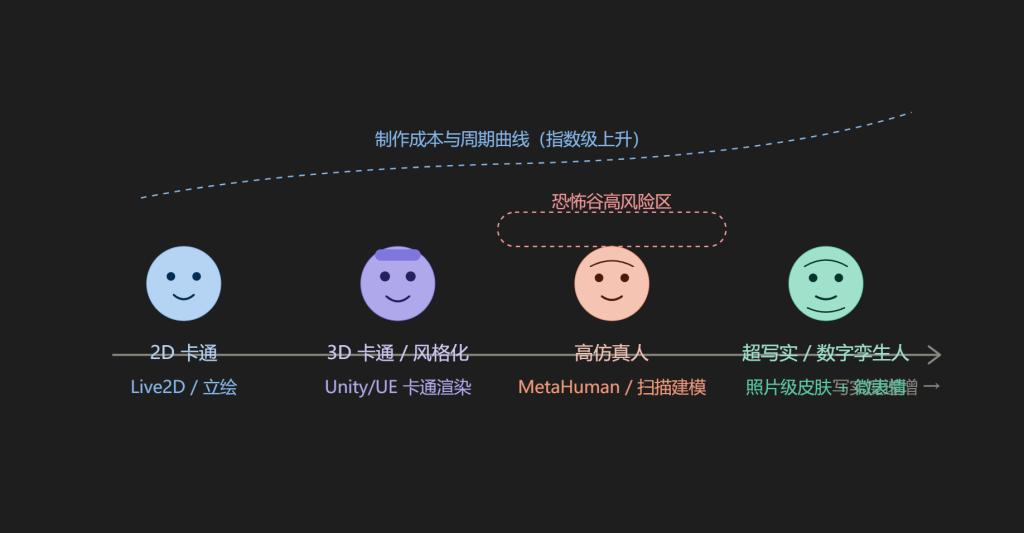
光谱上四个主要站位的详细说明:
1. 2D 卡通型
特征:二次元立绘 + Live2D 网格变形,只有上半身或头部,平面化表现。
技术要点:原画分层(眼/口/发/配件各自独立图层)→ Live2D Cubism 绑骨 → 摄像头面捕驱动。门槛低,一台普通电脑即可。
案例:B站大量个人势 VTuber;钉 钉/企业微信里的卡通客服头像。
优点:成本最低(几千元即可定制形象),风格讨喜,完美绕开恐怖谷。
缺点:严肃场景(政务、金融、新闻)可信度不足,动作表达受限。
2. 3D 卡通 / 风格化
特征:三维模型但保留卡通比例(大眼睛、简化材质),可 360° 旋转、全身动作。
技术要点:Blender/Maya 建模绑骨 + 卡通渲染(Toon Shading)+ 动捕或动画库驱动。您的 720yuntai.blend 工作流延伸到角色即是此路线。
案例:A-SOUL(乐华虚拟女团)、天猫"千喵"、各类品牌 IP 形象。
优点:可进三维场景做全景/VR 内容(与您的全景仿真天然兼容),形象版权完全自有。
缺点:建模周期以周/月计,动作不自然时"塑料感"明显。
3. 高仿真人
特征:接近真人外貌,但细看能分辨是 CG。是商用客服、播报数字人的主力形态。
技术要点:真人扫描或 MetaHuman 捏脸 + PBR 材质 + 骨骼重定向 + 语音驱动口型。腾讯智影、硅基智能、商汤如影等平台均可"拍 5 分钟视频克隆一个你"。
案例:新华社 AI 主播"新小浩"、央视"小 C"、各大银行数字柜员。
优点:真实感带来信任感,适合正式信息播报。
缺点:恰处恐怖谷边缘——口型、眼神稍有不同步就令人不适;克隆真人涉及肖像权与合规。
4. 超写实 / 数字孪生人
特征:追求照片级以假乱真,皮肤次表面散射、毛孔级纹理、微表情全套。
技术要点:4D 扫描 + 神经渲染(NeRF/3D Gaussian Splatting 是新趋势)+ 影视级渲染农场,单帧成本高。
案例:虚拟偶像 AYAYI、电影级数字替身(《阿丽塔》、数字王国为邓丽君做的复活演出)、英伟达发布会上黄仁勋的"数字分身"彩蛋。
优点:视觉冲击力最强,适合做品牌代言与影视内容。
缺点:成本数十万到上百万,无法实时交互(多为离线渲染),目前更多用于营销事件而非日常服务。
维度三:按应用场景分类
场景决定了前两个维度怎么选。六大主流场景对数字人的要求差异很大:
| 场景 |
典型组合 |
核心诉求 |
代表案例 |
关键挑战 |
| 智能客服/政务 |
高仿真人 + AI驱动 + 实时交互 |
回答准确率、口径合规 |
浦发"小浦"、各地政务大厅数字引导员 |
知识库维护成本、答非所问的投诉风险 |
| 直播带货 |
高仿真人 + 混合驱动 + 准实时 |
7×24 在线、话术转化 |
京东言犀、淘宝 AI 主播 |
平台合规(抖音要求 AI 直播显著标识)、弹幕互动能力 |
| 教育培训 |
2D/3D卡通或克隆教师 + 预生成 |
内容准确、可批量产出 |
网校 AI 讲师、您的 SadTalker 全景课程讲解视频 |
知识点零容错、学生注意力维持 |
| 新闻播报 |
高仿真人 + AI 驱动 + 单向播报 |
播报稳定、形象权威 |
新华社"新小浩"、央视网"小 C" |
突发新闻时效性、口型与文稿严格对齐 |
| 文娱偶像 |
2D/3D卡通 + 真人驱动 + 强交互 |
人设魅力、粉丝运营 |
初音未来、A-SOUL、洛天依 |
中之人风险、内容产能 |
| 医疗/心理陪伴 |
亲和风格化 + AI 驱动 + 实时 |
共情表达、隐私安全 |
心理陪伴 AI 助手、康复陪护数字人 |
伦理边界、误判风险最高 |
对教育场景多说一句:您目前走的"克隆形象 + 克隆语音 + 预生成讲解视频"是教学数字人最务实的形态——教学内容事先审定、零幻觉风险、离线可放,代价是牺牲实时问答能力。如果要往"课堂实时答疑数字人"升级,才需要引入 LLM + RAG 的全栈交互管线。
维度四:按交互能力分类
这是用户感知最直接的一条线,可以画成一个五级阶梯,越往上走技术栈越深:
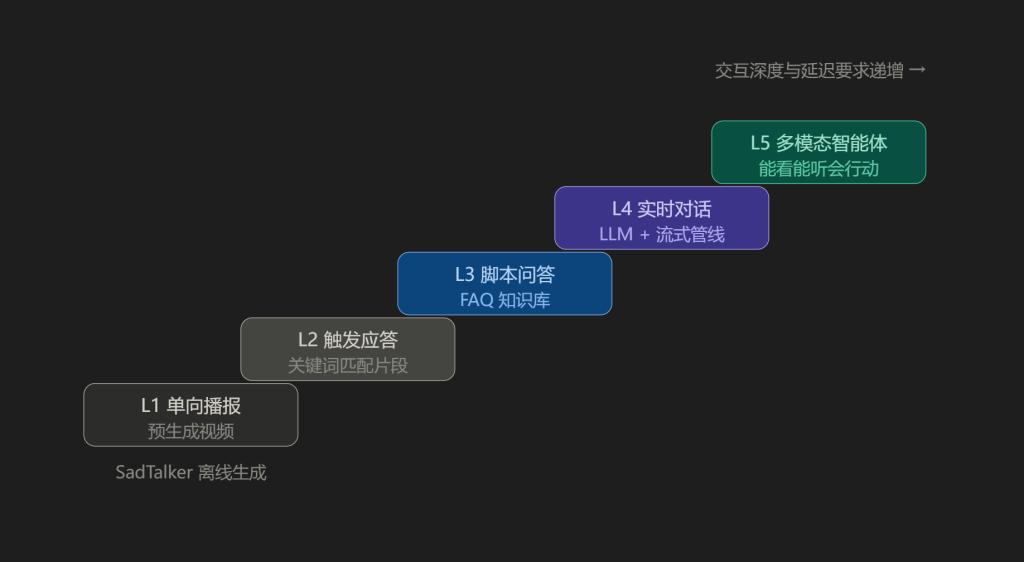
五级各自的内涵:
L1 单向播报型:纯预生成视频,观众没有任何输入通道。您的 SadTalker 教学视频即属此级。零延迟压力、零合规意外,是内容确定场景的最优解。
L2 触发应答型:预设关键词/按钮,命中即播放对应预录片段。展馆导览屏常见。交互是"假"的,但实现成本极低、稳定可靠。
L3 脚本问答型:挂 FAQ 知识库,用户自由提问,系统检索匹配答案后实时 TTS + 口型合成。电商客服数字人多在此级。答不上来时体验断崖式下跌。
L4 实时对话型:LLM 接管话术生成,ASR→LLM→TTS→表情驱动全流式,可开放域多轮对话。技术难点在首字延迟(>2 秒用户就出戏)与打断处理(barge-in)。
L5 多模态智能体型:数字人还有"眼睛"(看懂用户表情、手势、环境)并能调用工具完成任务(帮你查订单、调设备)。GPT-4o 级实时语音 + 视觉理解正在把这一级变为现实,目前属前沿探索区。
数字人选型对比与决策建议
最后把四个维度收拢成一张选型对照表。先回答三个问题,选型就清晰了:
问题一:内容是确定的还是要现场应变?
问题二:场景需要"信任感"还是"亲和力"?
问题三:并发规模多大?
| 您的需求画像 |
推荐组合 |
理由 |
| 教学讲解视频量产(您当前场景) |
克隆形象 + 预生成 AI 驱动 + L1 |
内容审定后零风险,离线可放,RTX 4060 Ti 即可跑 SadTalker |
| 课程实时答疑助手 |
风格化 3D + RAG 知识库 + L3/L4 |
卡通形象降低学生距离感,RAG 保证答案不超纲 |
| 虚拟仿真里的角色(全景实验内) |
3D 风格化 + 预置动画 + L1/L2 |
与 Three.js/全景管线兼容,file:// 离线要求排除云端交互 |
| 品牌代言 / 招生宣传 |
高仿真人或超写实 + L1 |
视觉冲击力优先,内容一次制作多次投放 |
一句话总结:形象写实度决定成本与信任感,驱动方式决定规模化能力,交互等级决定技术栈深度——而场景是唯一的裁判。选型的第一原则不是"上最强的",而是"为场景匹配刚够用的那一级",每往上一级,成本和风险都是倍数增长。
你想本地做数字人的话,三个务实选项
接受"半身口播":SadTalker 生成 + 透明背景 WebP/绿幕叠加,够用就继续(这是当前性价比最高、与你现有管线最匹配的路径)。
"全身+肢体"但接受半自动——用 MagicAnimate / Animate Anyone(GitHub 开源):给它一张全身图 + 一段参考动作视频,生成全身动作。需要装 PyTorch + AnimateDiff 系依赖,8GB 显存勉强能跑低分辨率;想 256×512 / 8 帧大概 1-2 分钟,但画质和稳定性目前还没到可交付级别。短期不建议投产。
"全身+肢体" + 出片可靠——用 SaaS API(腾讯智影/商汤如影/硅基智能)。成本:按秒/按角色计费,0.1-0.5 元/秒;合规:注意肖像授权与平台条款;效果:雨课堂这种水平。本地管线只做后期(绿幕/字幕/合成)。
建议
别追 SaaS 数字人那个效果。原因:
你现在的教学场景里,半身口播数字人 + 真人镜头切换已足够吸引注意力,SaaS 的"全身+肢体"在 720p 录屏 + PPT 切换里信息密度差别不大;
全身肢体数字人一旦做得粗糙,比半身口播更出戏(伪 3D 抖动、身体割裂);
教学视频的价值在内容节奏、画面一致性,不在数字人是否全身站立;
SaaS 订阅 + 人物授权 + 反复修改 prompt 的时间成本,远高于本地 SadTalker 一次跑通。


 2026年05月01日 2026年05月01日
 2026年04月11日 2026年04月11日
 2026年04月01日 2026年04月01日
 2026年01月22日 2026年01月22日
 2024年05月15日 2024年05月15日
 2024年03月18日 2024年03月18日
 2023年02月24日 2023年02月24日
 2023年02月23日 2023年02月23日
 2022年06月21日 2022年06月21日
 2022年05月26日 2022年05月26日