"嘴动+头微动"的本地口播数字人制作
一、主要功能与技术原理
SadTalker(CVPR 2023,西安交大 & 腾讯 AI Lab)
功能:单张人像照片 + 一段语音 → 生成会“说话”的头像视频,不仅动嘴,还带头部姿态、眨眼、眉毛等自然微动作。
技术原理:核心思想是把“说话”分解为头部运动建模 + 面部运动建模两条 3D 线索,再统一映射到生成空间:
ExpNet(表情系数网络):从音频回归出 3DMM 表情系数(lip region 深度感知,专门强化唇部)
PoseVAE(姿态变分自编码器):从音频生成与语音节奏相关的头部姿态序列(含眨眼、眉毛微动),用 VAE 保证姿态多样又自然
两路系数注入一个 3D 隐式面渲染 + Face Render(基于 StyleGAN2/NeRF 风格的隐式字典),渲染出每一帧面部,再贴回原图、只重绘嘴部半脸区域(fusion 模块),所以发丝、背景、身体全部保持原样
Wav2Lip(ACM MM 2020,印度 IIIT 团队)
功能:任意人脸视频(或照片)+ 任意语音 → 让嘴部精准对口型。它只做一件事:改嘴,别的一概不动。
技术原理:三段式流水线,非常“工程直给”:
唇同步判别器(Sync Net):预训练网络,判断“这一帧嘴型”和“这段音频”是否对齐(跨模态嵌入余弦距离)
生成器(Wav2Lip Generator):以“未对齐视频帧 + 对应音频梅尔频谱”为输入,生成嘴部区域;判别器以 Sync 偏差作为主损失,硬逼生成器把唇形对准音素
后处理:生成的新嘴部经高斯平滑贴回原视频帧,降低拼接闪烁
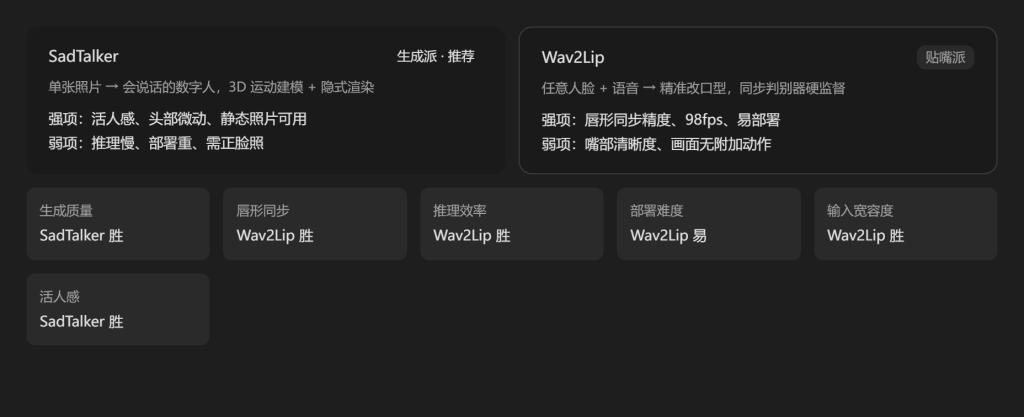
一句话记忆:SadTalker 是“3D 面部运动理解 + 隐式渲染”的生成派,Wav2Lip 是“同步判别器硬监督”的贴嘴派。
二、六维系统对比
| 维度 |
SadTalker |
Wav2Lip |
| 生成质量 |
✅ 优势。头部微动、眨眼自然,皮肤纹理来自 StyleGAN 渲染,观感“活的”;但偶有面部轻微漂移/身份偏移,分辨率上限低(原生 256,需 GFPGAN 补脸) |
⚠️ 嘴部常有模糊感(gan 版更锐,即你台账里的 wav2lip_gan.pth),清晰度依赖后处理;胜在画面其余部分 100% 原样,零漂移 |
| 唇形同步精度 |
良好但非极致——表情系数是间接映射,语速快时偶有迟滞 |
✅ 核心卖点。Sync 判别器直接以同步误差为损失,唇形-音素对齐精度业界标杆级,任何口音/语速都咬得住 |
| 输入适配要求 |
需单张正脸照,侧脸/遮挡/低分辨率容易崩;音频建议干净人声 |
输入极宽容:视频或照片均可、多人脸、任意角度都有办法(你本地就有 _diag_face.py 做人脸检测预检的实践);照片模式下帧间不连贯 |
| 推理效率 |
慢——每帧要过 ExpNet+PoseVAE+渲染+融合,8GB 卡上 1280×720 成片需逐段跑较长时间 |
✅ 快——你实测 RTX 4060 Ti 约 98 帧/秒,173s 成片几分钟出,适合批量、迭代、多人版本流水线 |
| 部署难度 |
⃠ 较高:依赖链长(face3d、GFPGAN、特定 torch 版本),Windows 下中文路径坑多(你专门沉淀过 sadtalker-windows-cn-path-fix 技能)、预训练权重分四包 |
✅ 低:一个 repo + 一个 512MB 权重即可开跑,环境干净,脚本化容易 |
| 适用场景 |
单张静态照片做数字人播报、虚拟教师/主播、对“活人感”要求高的成片 |
已有真人视频改口型(配音替换/多语言化)、快速批量生产、对同步精度要求苛刻、算力受限的产线 |
三、结构化结论
下面这张对比卡片直观汇总两者定位:
四、选型结论
一句话总结:要“活人感”选 SadTalker,要“快且对口精准”选 Wav2Lip。这个结论可以进一步落地成三条决策规则:
输入是单张照片(无现成视频)→ 必选 SadTalker。Wav2Lip 的照片模式帧间不连贯,做不了数字人播报;你的张建立版/吴校版头像场景正是 SadTalker 的主场。
已有真人讲解视频、只需换配音/换语言 → Wav2Lip 更划算。98 帧/秒的吞吐意味着几分钟出片,多版本迭代(多配音、多语种)成本极低,代价只是嘴部略糊,可用 wav2lip_gan 权重 + 后处理补。
8GB 显存下的混合策略(你已在用):SadTalker 做最终成片的数字人层,Wav2Lip 做快速预览/批量试错——先 Wav2Lip 快速验证“这段配音+这段画面对不对”,定稿后再上 SadTalker 精渲染,兼顾迭代速度与交付质量。
注意一代际差异:Wav2Lip 是 2020 年方案,唇同步靠判别器硬监督但没有 3D 理解;SadTalker(2023)代表了“音频→3D 面部运动→隐式渲染”的路线。更新的方向(如 EMOPortraits、Hallo、EchoMimic 等扩散模型系)在质量上又高一档,但显存需求和推理时间也高数档,在 8GB 卡上目前 SadTalker + GFPGAN 补脸仍是最优性价比组合。


 2026年05月01日 2026年05月01日
 2026年04月11日 2026年04月11日
 2026年04月01日 2026年04月01日
 2026年01月22日 2026年01月22日
 2024年05月15日 2024年05月15日
 2024年03月18日 2024年03月18日
 2023年02月24日 2023年02月24日
 2023年02月23日 2023年02月23日
 2022年06月21日 2022年06月21日
 2022年05月26日 2022年05月26日