第 5 步:推理合成(1-GPT-SoVITS-TTS → 1C)
5.1 先选对模型:GPT / SoVITS 各选哪一款
训练产物命名规则:实验名-e轮数-s步数.ckpt/.pth(如 myvoice-e10-s8123)。e = epoch(轮数)、s = step(步数),同一次训练里文件按时间顺序保存 → e/s 越大 = 越接近训练终点。
选模三条规则(记牢):
30. 默认选 e 和 s 都最大 的那一对。训练正常跑完时,最后保存的就是"毕业模型"——音色最像素材、最稳定。
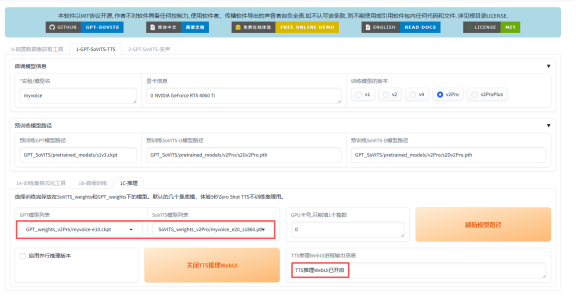
31. GPT 和 SoVITS 必须选同一 e/s 配对(两个下拉列表选同一个名字,如都选 myvoice-e10-s8123)。GPT 管文本语义、SoVITS 管音色,同一对的内部参数是对齐训练的,混搭虽能跑但音质打折。
32. 别选到底模。下拉列表里混着预训练模型(名字像 s1bert25hz-2kh-longer-epoch=68e-step=50232.ckpt、s2G488k.pth,或名字里不带你的实验名)——选错 = 听到的是通用音色,不是你的克隆音。认准自己实验名前缀的那一对。
什么时候不选最后一个:
情况 |
处理 |
训练中途爆显存/中断,最后文件残缺 |
往前退一个(e-1 或 s 小一档) |
合成吞字/复读/电音严重(疑过拟合) |
试 e 稍小的版本对比 |
想对比效果 |
同 e 系选 s 差 1–2 档的模型,合成同一句话试听 |
5.2 推理操作
33. 顶部选 v2Pro 版本(8GB显存的选择,16GB可选V4) → 点 「刷新模型路径」 → 下拉选你刚训练的模型。
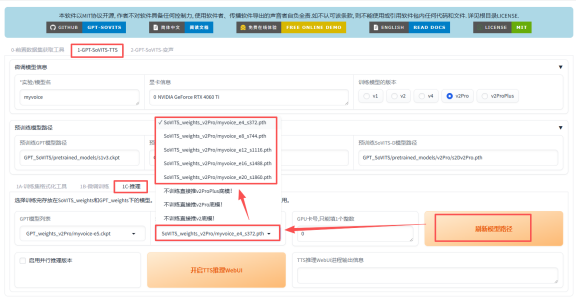
34. 点 「开启 TTS 推理WebUI」,会再开一个新页面(端口 9872)。
35. 上传参考音频(5 秒左右最佳,建议用训练集切片里的某一段)→ 填参考音频的文本(它说了什么就填什么,语种一致)。


 2026年05月01日 2026年05月01日
 2026年04月11日 2026年04月11日
 2026年04月01日 2026年04月01日
 2026年01月22日 2026年01月22日
 2024年05月15日 2024年05月15日
 2024年03月18日 2024年03月18日
 2023年02月24日 2023年02月24日
 2023年02月23日 2023年02月23日
 2022年06月21日 2022年06月21日
 2022年05月26日 2022年05月26日